核心技术

已实现

从唇部动作、预设表情到对话交互,以下能力已在真机上实现。

唇音同步

从文本到唇部动作

  1. 语音输入文本
  2. TTS 语音合成
  3. 动作预测音频-动作模型
  4. 物理执行多维舵机指令
  5. 机器人唇部动作

用真实机器人的配对数据,建立嘴型与动作之间的映射。

典型音素与嘴型对照
音素嘴型类别
/p/ /b/ /m/双唇音
/f/ /v/唇齿音
/θ/ /ð/齿间音
/u/ /o/ /w/圆唇音
/a/ /æ/开元音

典型发音

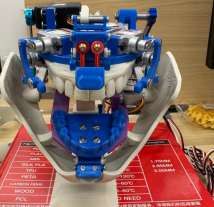
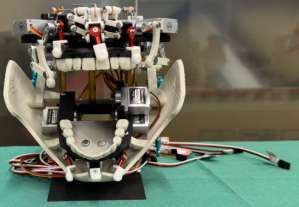
依次为:爸爸、拜拜(双唇音),飞(唇齿音),乌龟(圆唇音)。EVA 二代口部实拍。

机器人语音由 AI 合成

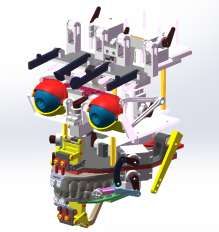
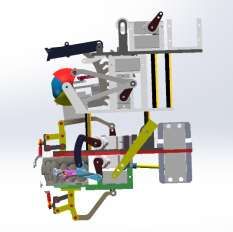
EVA 二代的口型使用 13 路通道,由中英文语音实时驱动。
仿生面部与表情

软硅胶嘴唇,上唇、下唇与嘴角的多执行机构协同,呈现预设表情。

机器人回复中的情绪会触发相应的预设表情,平静时有自然的眨眼。

多语言对话交互

对话可以跟随用户在 14 种语言之间切换(语音识别和回复)。

支持长期记忆,并可按角色定制人设和声音。

可切换的语言包括:中文(普通话)、粤语、英语、日语、韩语、俄语、越南语、西班牙语、法语、德语、阿拉伯语、葡萄牙语、意大利语、波兰语。

情绪状态

机器人带有模拟的情绪状态:开心、伤心、不高兴、吃惊、害羞、困六种心情各自累积、逐渐淡去,聊完再来时心情仍然保留,部分中文音色的语气也随之调整。

视觉理解与主动交流

摄像头定期观察周围场景,视觉模型生成的描述会进入对话和记忆;用户安静一段时间后,机器人会根据所见所闻主动开口。

研发进展

以下能力仍处于开发阶段。

研发中

眼神跟随

已有实机演示,仍在开发中。

研发中

模型驱动的表情

已用真实机器人采集约 1.6 万组表情图像和对应控制指令。真人表情驱动机器人数字形象的流程已跑通,下一步落到真机。

已开发,尚未开放

以下能力已完成技术开发,目前未对用户开放。

尚未开放

人脸识别与声纹识别

用于区分和识别不同的人。涉及个人生物特征信息,启用前须取得用户的单独同意,并完成合规评估。

尚未开放

人脸表情识别

识别用户的面部表情,使机器人的回应更贴合场景。同样须经用户同意并完成合规评估后才会启用。

让交流成为连接

商务合作,请联系 Kathy Hu。

商务合作